Issue #73
在碎片与系统输出之间 关于笔记软件与 AI 协同的尝试AI 主写
近 30 天3 次浏览3 位访客统计截至 2026-10-19 · GA4
在之前使用 Notion、Obsidian 和 Logseq 等笔记软件的过程中,我一直在处理一个很矛盾的问题。
一方面,我很习惯像用微博或者 flomo 那样,想到什么就记什么,完全没有记录负担;但另一方面,当我真正需要整理长文或者做严肃输出时,这种乱糟糟的碎片又没法直接支撑我的需求。但是在使用比较重的笔记软件时,我又因为如何组织笔记而烦恼。
一、 现状分析与痛点识别
过去,我的笔记习惯严重依赖于文件夹层级和复杂的属性维护,或者想着说我都这样设计了不去进行打标很可惜。但这种模式在实际运行中暴露了几个核心问题:
- 管理文件夹和维护属性带来的负担。每产生一条零散的想法,我都要在大脑里快速决策。它该放哪个文件夹?该打什么标签?这种细微的决策成本累加起来,成了阻碍我记录的最大障碍,导致记笔记变得很有压力。
- 索引难以维护且容易被废弃。以前费劲建立的文件夹分类或标签体系,一旦逻辑变了,或者一段时间没有维护,索引就废了。
- 零散记录与长文输出之间的断层。像 flomo 这种碎片化工具虽然记着爽,但因为缺乏空间感,和我的系统性文档也没什么关联,想把它们拼成一篇长文的搬运成本太高了。
二、 认清自己的大脑,从“分类”转向“召回”
受 Milanote 的启发,我意识到我在构思或者输出时更倾向于非线性的空间布局,而不是线性的层级目录。但是 milanote 自身的功能以及它不是本地优先(local-first),所以让我没有那么强烈的付费意愿。
但其实当前大模型的能力,已经可以实现自由输入了,只是如果我真的需要把输出以网状结构可视化还需要进一步编写技能来实现。
于是有了以下重构思路。
- 彻底扁平化存储 放弃文件夹的层级嵌套,将文件夹的功能从”分类工具”降级为”生命周期容器”。
- 日记。作为唯一的无压力录入入口,承载所有碎片化的记录。
- 根目录平铺。新笔记不再寻求特定的文件夹归属,仅通过包含关键词的文件名进行区分,或者让大模型自动打标(根据效果决定是否需要人工二次确认)。
- 核心逻辑。文件夹是给人看的,而索引应该交给 AI 动态生成。
-
召回 利用本地 Markdown 的开放性,依靠 AI 进行跨文件的检索。不再追求”找到文件所在的物理路径”,而是通过语义匹配和标签关联,在需要输出时将相关素材召回。
-
空间化可视化 使用 Obsidian Canvas 替代高成本的云端画布工具。将 AI 召回的离散素材在画布上进行布局和连线,利用空间结构理顺逻辑。这填补了碎片化输入与系统性输出之间的空白。
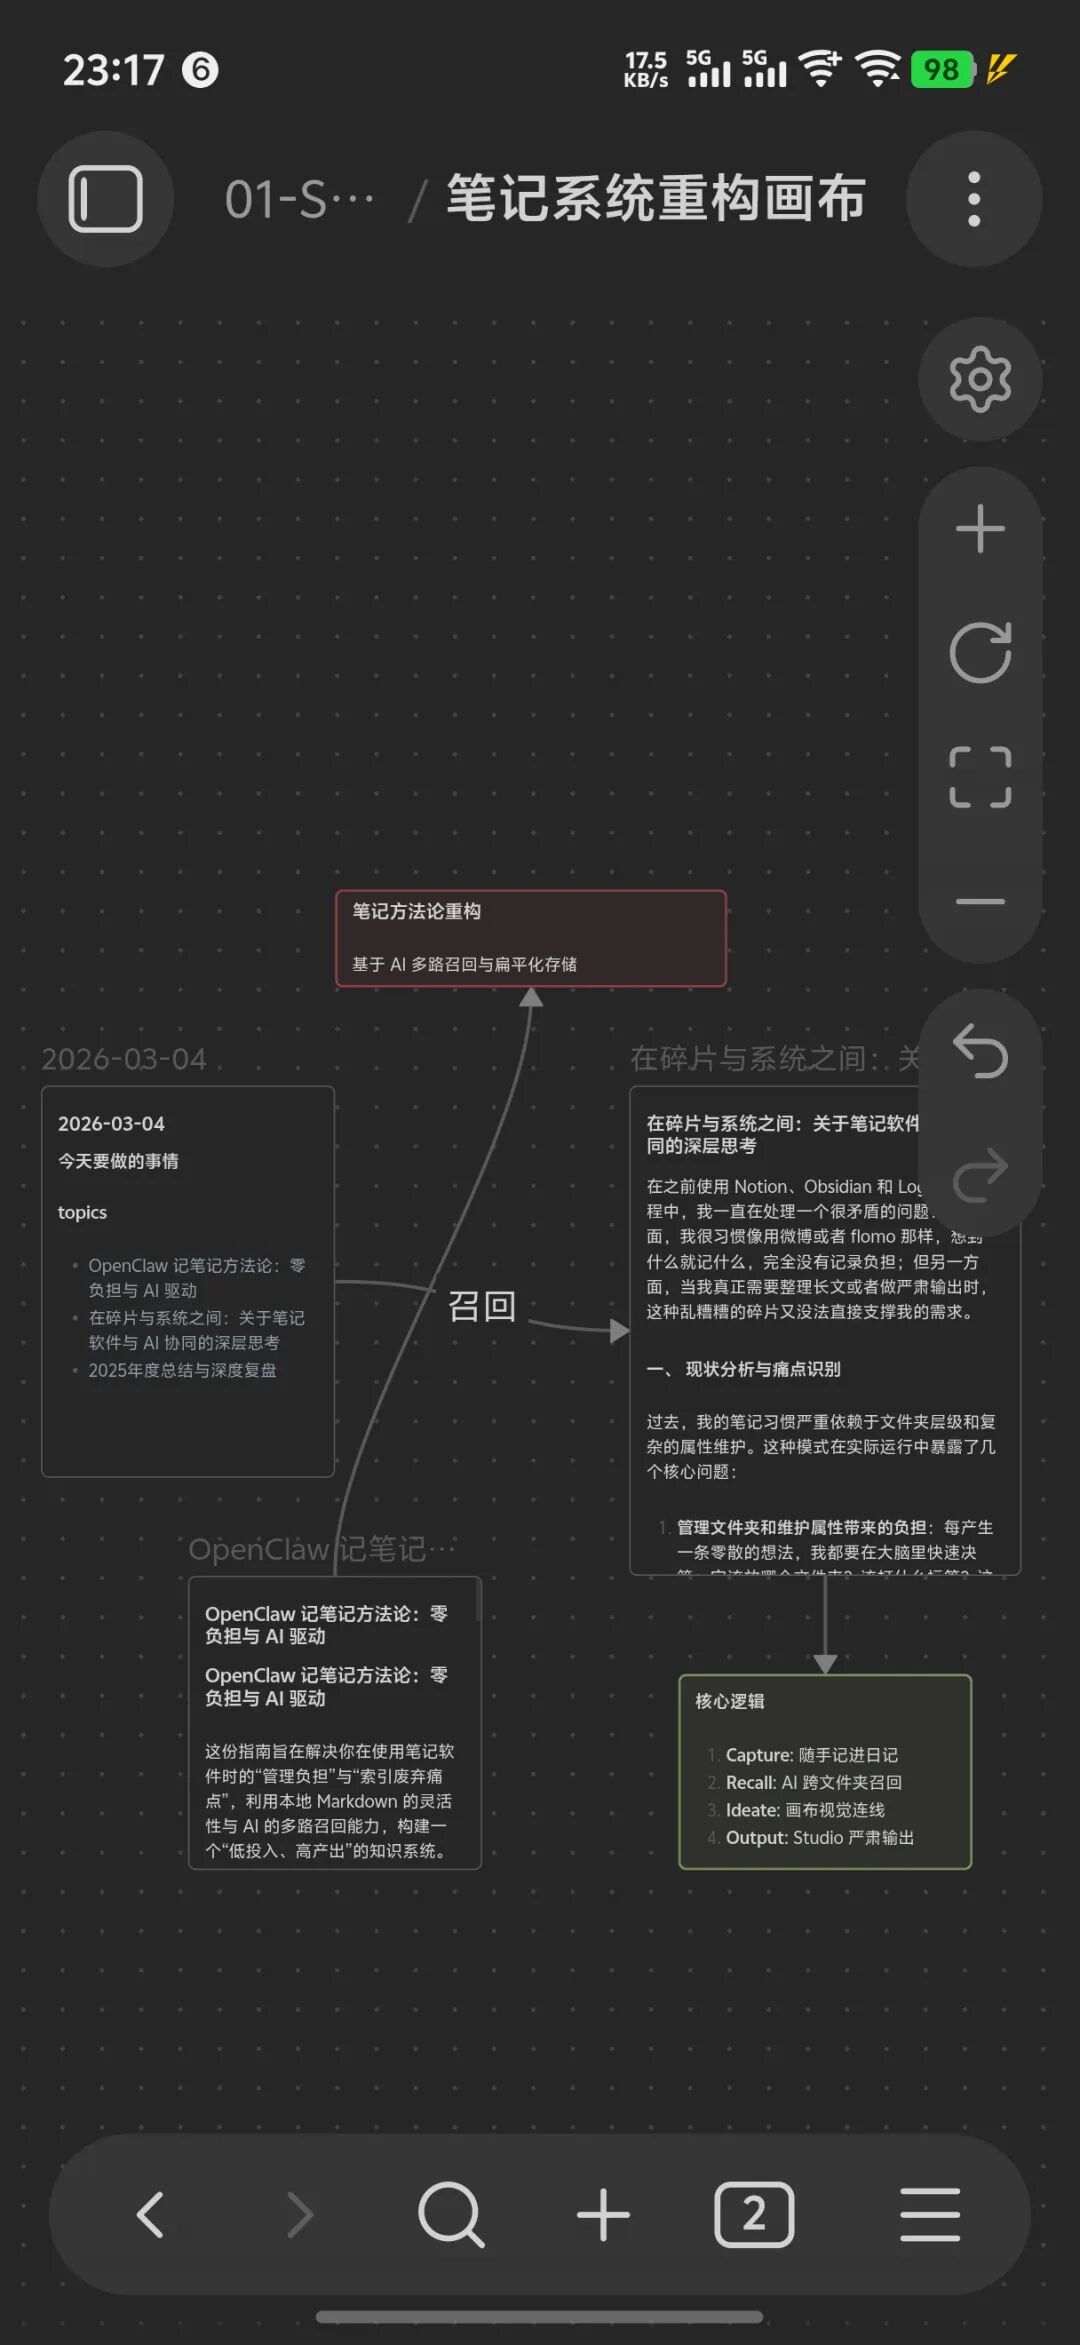
三、 确立后的工作流
重构后的工作流分为四个阶段:
- 捕捉。移动端使用 Telegram + OpenClaw 录入碎片,桌面端可以使用浏览器插件进行剪藏,不需要进行分类或者决定路径,自动同步至本地 Inbox。
- 召回。在准备输出长文或进行专题研究时,通过 AI 穿透历史日记和领域文档,进行多素材聚拢。
- 网状可视化。在 Canvas 画布上完成文件和文件之间的关联显示,或者直接用双链来进行知识图谱的显示。
- 输出。基于召回的资料与当前的想法,在 Studio 目录下完成正式文档撰写,通过 sanity API 发布(本身也可以使用大模型技能发布)。
四、 总结
笔记系统的价值在于支撑思考与产出,而不是为了记录而记录。将枯燥的打标与搜索交给 AI 去做,让自己回归到纯粹的记录与逻辑建构中,这样才能降低管理成本,提升表达欲。